Software Factory IA : vos agents attendent une CI de quatre heures
Avant de multiplier les agents, rendez vos tests rapides sur la machine. Ce que des agents ont changé dans une CI de nuit, puis le cas d'une app mobile.

Quand on parle de software factory IA, tout le monde voit la même image : une flotte d'agents qui prennent des tickets, codent en parallèle et livrent pendant que l'équipe dort. Les pages qui définissent le terme parlent d'agents de code, de la place des humains et des contrôles à imposer aux agents. Alors on commence par compter les agents.
La première étape n'est pas le nombre d'agents, c'est la vitesse de vos tests. Pour avoir une software factory efficiente, il faut d'abord être capable de lancer tous vos tests rapidement, sur la machine. Des agents qui attendent le lendemain matin pour savoir s'ils ont cassé quelque chose ne servent à rien.
Je le dis aussi nettement à cause de ce que j'ai vu chez un client. Leur CI, la chaîne qui lance les tests automatiquement, tournait la nuit, et les tests d'intégration mettaient plus de quatre heures. Vous écrivez du code dans la journée, vous apprenez le lendemain s'il tient debout.
J'ai lancé des agents dessus pour essayer d'optimiser tout ça. Sur ma machine, j'ai réussi à faire passer ces tests d'intégration de 4h27 à 4 min 30. Relisez les unités : des heures d'un côté, des minutes de l'autre.
Ce chiffre est mesuré sur ma machine, et je n'affirme rien ici sur la CI de nuit du client. Ce que je peux raconter, c'est ce que les agents ont changé pour y arriver.
Les agents ont commencé par les bases de données que personne n'avait envie de regarder
Au départ, il y a une CI qui n'était pas optimisée. Les tests d'intégration tournaient contre des bases de données hébergées, et il y en avait huit. L'application sert elle-même beaucoup de clients différents, alors chaque base représentait un parcours différent, un état différent de l'application. Chacune pesait entre 100 et 150 Go.
Pour lancer les tests sur un poste, il fallait d'abord y faire tenir ces bases. Elles tournaient sur Oracle, et l'édition gratuite d'Oracle, Oracle Database Free, tourne dans un conteneur Docker en local, avec une limite de 12 Go de données. Tout le problème était de passer sous cette limite.
Ces bases, personne n'avait envie de les regarder, justement parce qu'elles étaient trop grosses. C'est sur cette question que j'ai lancé les agents : comment réduire leur taille jusqu'à pouvoir les faire tourner en local.
Ça a marché, pour une raison toute bête : la majorité des données n'étaient pas nécessaires aux tests. Une base de 150 Go est parfois tombée à 4 Go. À ce poids, elle tourne sur Oracle en local.
D'autres optimisations ont suivi. Dans certains tests d'intégration, l'application démarrait 70 fois alors qu'il n'y en avait pas besoin, et une dizaine de fois suffisait. Puis est venue la parallélisation. Oracle permet de créer des copies à partir de la base existante, et ces copies se lancent très rapidement.
Ce travail de fouille, personne ne voulait s'y coller, et ce sont les agents qui l'ont fait. Ce que ça permet tient en peu de mots : une boucle agentique très rapide, sur la machine. L'agent écrit, lance les tests, lit ce qui casse, corrige et recommence, sans attendre personne.
Un humain peut attendre demain matin, un agent non
Une CI de nuit n'a rien d'absurde quand ce sont des humains qui codent. Ils peuvent vérifier le lendemain, regarder ce qui s'est passé, et reprendre. Le rythme de la chaîne colle à peu près à celui de la personne.
Un agent, lui, a besoin d'un feedback rapide. Il ne rentre pas chez lui le soir. Il termine sa modification et il lui faut la réponse tout de suite pour décider quoi faire ensuite. Si la réponse arrive demain, il s'arrête, ou il continue sans savoir.
Et il y a le volume. Là où un humain peut faire un ticket, un agent peut en faire quatre ou cinq, et vous pouvez avoir dix agents en permanence. À ce débit, vous êtes obligé d'avoir des tests rapides. Sinon vous vous retrouvez avec des boucles de feedback très, très lentes, et tout ce que vos agents produisent vient s'entasser devant la même suite de tests. Le goulot, c'est elle.
Imaginez le lendemain matin d'une CI de nuit avec une équipe d'agents. Le travail de toute une journée arrive d'un bloc, et il faut commencer par retrouver quelle modification a fait tomber quel test.
Je parle de tous les tests. Les tests d'intégration, les tests end-to-end (ceux qui traversent l'application de bout en bout) et les autres : il faut essayer de les faire passer le plus rapidement possible. Et sur la machine, là où l'agent travaille. Il faut aussi pouvoir en ajouter facilement.
Même raisonnement qu'avec les skills Claude Code envoyés en prod au doigt mouillé : il faut mesurer avant de diffuser. Pour un agent qui code, la mesure s'appelle une suite de tests, et elle ne lui sert que si elle répond pendant qu'il travaille.
Sur l'application mobile de Monka, j'ai vu ce que ça donne quand on va au bout de cette idée.
Chez Monka, les agents testent eux-mêmes ce qu'ils viennent d'écrire
Là-bas, on a fait en sorte de pouvoir tout lancer en local : l'application entière, le backend, la configuration, et des environnements de test déjà pré-remplis. Tout ce dont un agent a besoin pour vérifier son travail se trouve déjà sur le poste.
Restait à tester pour de vrai, dans un simulateur. Des serveurs MCP s'en chargeaient, notamment XcodeBuildMCP (devenu MobileBuildMCP, maintenu sous l'organisation getsentry sur GitHub), un serveur MCP qui donne aux agents des outils pour travailler sur des projets iOS et macOS. Ils pilotaient les simulateurs de façon identique et reproductible, pour que chaque agent teste directement dans l'app la fonctionnalité qu'il venait d'implémenter.
C'était la clé pour tester efficacement. Avec cinq agents qui tournent, chacun peut valider lui-même son travail avant de vous le rendre.
Vous avez une objection en tête, et c'est la bonne : le poste ne tiendra pas. Le goulot quitte la CI et s'installe sur votre machine. Dès que vous lancez cinq simulateurs Xcode en même temps, ça consomme à fond les ressources, et les tests end-to-end tirent dessus au même moment.
Il y a aussi un problème moins noble. Tous ces lancements de tests en local génèrent des artefacts, et tous les trois jours il fallait supprimer environ 100 Go de données. C'était pénible.
L'objection est juste, et elle montre où se trouve le plafond du poste, donc ce qu'il faut construire ensuite.
Les sandboxes viennent après, quand votre software factory sait déjà se tester vite
La suite logique, ce sont des environnements éphémères, ou des sandboxes. Après des séances de ménage de disque à répétition, un environnement qui disparaît une fois le travail fini, je vois très bien l'intérêt.
Surtout, ça permet de démultiplier. Un orchestrateur lance cinq ou six agents sur les tickets et, à la fin, il merge si tout est bon. C'est le sujet de l'article sur le harnais d'agents en entreprise, qui couvre les boucles, les sandboxes et les skills.
Seulement, l'ordre compte. « Si tout est bon », ça veut dire si les tests passent. Ce sont eux qui donnent le feu vert au merge, et l'orchestrateur ne va pas plus vite qu'eux. Installez des sandboxes devant une suite qui dure des heures et vous aurez multiplié l'attente, rien d'autre.
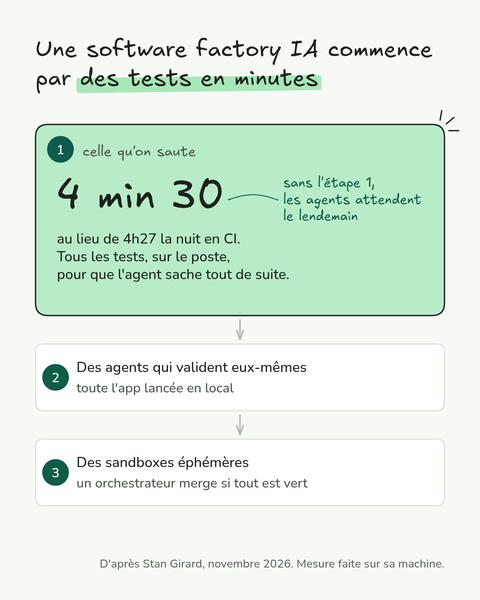
Alors avant de compter vos agents, sortez un chronomètre. Lancez votre suite de tests complète sur un poste, intégration et end-to-end compris, et notez le temps. S'il se compte en heures, vous tenez votre premier chantier. Prenez rendez-vous si vous voulez que je regarde ce chiffre avec vous.
La flotte d'agents peut attendre un peu. Pour l'instant, c'est elle qui attend votre CI.